大數據開發中最常用的編程語言與數據處理和存儲服務
引言
隨著數據量的爆炸式增長,大數據開發已成為企業挖掘數據價值的關鍵環節。在大數據生態中,選擇合適的編程語言和數據處理、存儲服務至關重要。本文將介紹大數據開發中最常用的編程語言,以及主流的數據處理與存儲服務,幫助開發者快速構建高效的數據管道。
一、大數據開發中最常用的編程語言
1. Java
Java 是大數據生態的基石,Hadoop、Spark、Flink、Kafka 等核心框架均主要使用 Java 開發。Java 擁有成熟的 JVM 生態、豐富的類庫和強大的跨平臺能力,適合構建大規模分布式系統。
2. Scala
Scala 運行在 JVM 上,兼具面向對象和函數式編程特性。由于 Apache Spark 和 Apache Kafka 均使用 Scala 編寫,Scala 在數據工程領域廣受歡迎。其簡潔的語法和強大的并發模型能夠顯著提升開發效率。
3. Python
Python 憑借簡單易學、豐富的科學計算庫(如 Pandas、NumPy)和活躍的社區,成為數據分析和機器學習首選語言。PySpark、Dask 等框架讓 Python 也能處理大規模數據,適合快速原型開發和數據探索。
4. SQL
雖然 SQL 不是通用編程語言,但在大數據開發中地位不可替代。Hive、Spark SQL、Presto/Trino、Flink SQL 等允許開發者用聲明式語句進行數據查詢和轉換,極大降低了大數據處理門檻。
5. Go 和 Rust
隨著云原生和實時數據處理的發展,Go 和 Rust 逐漸進入大數據領域。Go 適合構建高并發的數據采集和微服務,Rust 則用于對性能要求極高的場景(如流處理引擎)。
二、數據處理服務
數據處理服務負責對海量數據進行清洗、轉換、聚合和分析。常見服務包括:
- Apache Hadoop MapReduce:經典的批處理框架,適合離線大規模數據處理,但延遲較高。
- Apache Spark:基于內存的分布式計算引擎,支持批處理、流處理、機器學習和圖計算,性能遠超 MapReduce。
- Apache Flink:原生流處理框架,提供 exactly-once 語義和低延遲,適合實時數據處理。
- Apache Kafka Streams:基于 Kafka 的輕量級流處理庫,適合構建實時數據管道。
- Apache Beam:統一的編程模型,可運行在 Spark、Flink 等引擎上,實現批流一體。
- 云托管服務:如 AWS Glue、Google Cloud Dataflow、阿里云實時計算 Flink 版,提供免運維的數據處理能力。
三、數據存儲服務
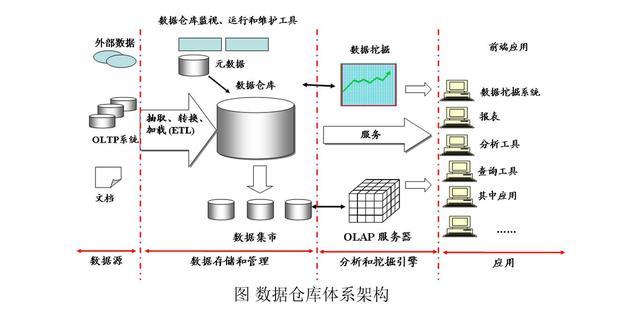
數據存儲服務為大數據提供持久化、高可靠、可擴展的存儲方案。主要分為以下幾類:
- 分布式文件系統:HDFS(Hadoop Distributed File System)是大數據存儲的基石,適合海量文件存儲。
- NoSQL 數據庫:
- HBase:基于 HDFS 的列式數據庫,支持海量數據的隨機讀寫。
- Cassandra:高可用的分布式列存儲,適合寫多讀少場景。
- MongoDB:文檔型數據庫,適合半結構化數據。
- 對象存儲:如 AWS S3、阿里云 OSS、騰訊云 COS,提供低成本、高擴展的存儲,常與 Spark、Hadoop 集成。
- 數據倉庫:
- Apache Hive:基于 Hadoop 的數據倉庫,提供 SQL 接口。
- ClickHouse:列式 OLAP 數據庫,查詢速度極快。
- Apache Doris / StarRocks:新一代 MPP 數據倉庫,支持實時分析。
- Snowflake / BigQuery / Redshift:云原生數據倉庫,彈性擴展。
- 時序數據庫:如 InfluxDB、TimescaleDB,用于存儲監控指標和 IoT 數據。
- 圖數據庫:如 Neo4j、JanusGraph,用于社交網絡和知識圖譜。
四、如何選擇
選擇編程語言和數據處理存儲服務時需考慮以下因素:
- 數據規模與延遲要求:批處理可選擇 Java/Scala + Spark/HDFS;實時處理可選 Flink/Kafka;交互式分析可選 Presto/ClickHouse。
- 團隊技能:Python 團隊可優先使用 PySpark 和 Pandas;Java 團隊更適合 Hadoop/Spark 原生開發。
- 成本與運維:云托管服務減少運維負擔,但可能產生較高費用;自建集群初期成本低,但需專業運維。
- 生態整合:確保所選語言和存儲服務能與現有系統(如數據湖、消息隊列)無縫集成。
##
大數據開發中,Java 和 Scala 是構建核心框架的主力,Python 和 SQL 則因易用性成為數據分析和查詢的利器。數據處理服務從批處理的 Hadoop/Spark 到流處理的 Flink/Kafka,存儲服務從 HDFS 到云數據倉庫,提供了豐富的選擇。開發者應根據業務需求、團隊能力和成本預算,組合使用這些語言和服務,構建高效、可靠的大數據平臺。