當機器人進廠開啟“打工人”模式,存儲挑戰如何化解?——數據處理與存儲服務的關鍵角色
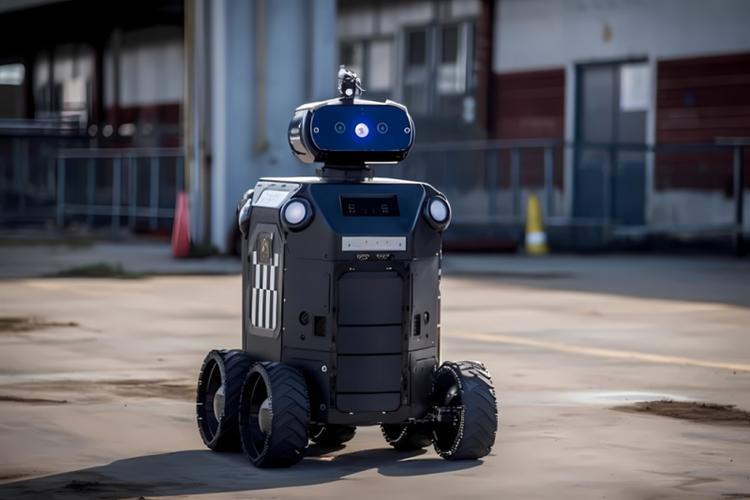
隨著工業4.0和智能制造的深入推進,越來越多的機器人走進工廠,成為生產線上的“新員工”。它們不知疲倦地執行焊接、搬運、裝配、質檢等任務,開啟了一種全新的“打工人”模式。機器人高效運轉的背后,是海量數據的實時產生、處理與存儲。從傳感器信號到視覺圖像,從運動控制日志到預測性維護記錄,每一秒都有大量的數據在工廠網絡中流動。面對這些挑戰,傳統的數據處理和存儲方案往往捉襟見肘制。存儲挑戰究竟如何化解?答案在于構建面向工業場景的專業數據處理與存儲服務體系。
一、機器人進廠帶來的數據洪流
工業機器人通常配備多種傳感器,包括力矩傳感器、位置編碼器、視覺攝像頭、激光雷達等。以一臺六軸機器人為例,其每秒可能產生數萬條運動軌跡數據點、數十幀高清圖像,以及各種環境參數。當數十臺甚至上百臺機器人協同工作時,數據量會以PB級快速增長。這些數據具有以下特征:
- 高并發寫入:多機器人同時產生數據,要求存儲系統能夠承受高吞吐量的并發寫入。
- 低延遲需求:運動控制和實時避障需要毫秒級的讀寫響應,否則可能導致生產事故。
- 混合數據類型:包含結構化數據(如狀態碼)、半結構化數據(如JSON日志)和非結構化數據(如圖像、點云)。
- 長周期留存:部分數據需保留數年以滿足質量追溯和合規要求,同時也有大量臨時數據需快速清理。
二、存儲挑戰的具體表現
- 性能瓶頸:傳統機械硬盤(HDD)的IOPS有限,難以應對高并發實時寫入,容易造成數據堆積和丟失。
- 容量擴展困難:孤立的存儲設備無法線性擴展,當機器人數量增加時,需要頻繁停機擴容。
- 數據孤島:不同廠商的機器人系統往往采用私有數據格式,導致存儲資源無法統一管理和共享。
- 成本壓力:全閃存陣列雖然性能高,但大規模部署成本昂貴;而純HDD方案又無法滿足實時性要求。
- 安全與可靠性:工廠環境中的震動、溫度變化以及潛在的 cyber attack,對數據持久性和安全性構成威脅。
三、化解之道:數據處理與存儲服務的關鍵能力
為了應對上述挑戰,企業需要引入專門面向工業場景的數據處理與存儲服務,構建從邊緣到云端的層次化體系。具體化解策略包括:
1. 邊緣計算與邊緣存儲
在機器人本體或車間邊緣部署輕量級存儲節點,就近處理實時性要求高的數據。邊緣節點可采用NVMe SSD,提供微秒級延遲,并支持數據過濾和聚合,僅將關鍵數據上傳至中心存儲,減少帶寬消耗。
2. 分布式存儲架構
采用軟件定義存儲(SDS)構建分布式集群,通過Scale-out方式實現容量和性能的線性擴展。對象存儲適合存放圖像和日志等非結構化數據,而塊存儲則用于數據庫和虛擬機。分布式文件系統(如Ceph、HDFS)可統一命名空間,打破數據孤島。
3. 智能分層與生命周期管理
基于數據熱度自動分層:高頻訪問的數據留在全閃存層,溫數據放入混合層,冷數據歸檔至大容量HDD或磁帶庫。通過策略引擎定義生命周期規則,例如機器人視覺圖像保留30天后自動降級,以降低成本。
4. 數據壓縮與去重
在寫入前進行實時壓縮和全局去重,尤其對于多機器人拍攝的相似圖像,去重率可達50%以上,顯著節省存儲空間。同時采用高效的編碼算法,減少CPU開銷。
5. 統一數據平臺與API
提供標準化的S3、NFS、iSCSI等接口,兼容不同機器人品牌的數據接入。通過RESTful API和消息隊列(如Kafka)實現數據流水線,方便上層AI應用進行訓練和推理。
6. 高可靠與安全設計
存儲系統需支持多副本、糾刪碼和快照,確保數據不丟失。同時集成加密、訪問控制和審計日志,滿足工業安全標準。對于關鍵控制數據并,可采用持久內存(PMem)保證斷電情況下的數據完整性。
四、實踐案例與展望
某汽車制造工廠部署了200臺焊接機器人,每條產線每秒產生1.2GB數據。通過部署邊緣存儲節點和中心分布式存儲集群,實現了數據寫入延遲低于五分鐘內,存儲成本下降40%,同時利用歷史數據訓練預測性維護模型,將非計劃停機減少了30%。
展望未來博會,隨著5G和AI技術的成熟,機器人將更加自主,數據量也將持續爆炸。存儲服務需要進一步向智能化演進:例如利用AI進行數據放置優化、基于意圖的存儲管理,以及存儲級內存(SCM)的廣泛應用。唯有如此,才能讓機器人“打工人”無后顧之憂,真正釋放智能制造的全部潛力。
機器人進廠不是簡單的設備替換,而是對整個數據基礎設施的升級考驗。通過邊緣與云端協同、分布式架構、智能分層與安全策略,企業能夠化解存儲挑戰,讓數據處理與存儲服務成為智能工廠的堅實底座。